Agentes industriales basados en LLMs y datos de series temporales
Los modelos de lenguaje de gran tamaño, o LLMs, permiten utilizar el lenguaje natural como una interfaz común para acceder a esta información. El usuario puede formular una pregunta sin conocer el nombre exacto de las variables, la estructura de la base de datos o la ubicación de un procedimiento dentro de un manual. A partir de esta pregunta, el sistema interpreta la intención y selecciona la fuente de conocimiento más adecuada para proveer la respuesta más adecuada para el usuario.
Existen técnicas como el RAG (Retrieval-Augmented Generation) [1], que permiten consultar manuales y documentación técnica mediante lenguaje natural. Para ello, el sistema localiza los fragmentos más relacionados con la pregunta y los utiliza como contexto para elaborar la respuesta. Sin embargo, cuando es necesario representar el significado de los conceptos, unificar terminología o establecer relaciones entre elementos del proceso, resulta más adecuado recurrir a las ontologías.
Una estructura semántica organiza la información de forma que el significado de sus elementos y las relaciones entre ellos sean explícitos y comprensibles tanto para las personas como para los sistemas informáticos. Las ontologías permiten formalizar esta estructura, definiendo los conceptos de un dominio, sus propiedades y las relaciones que existen entre ellos.
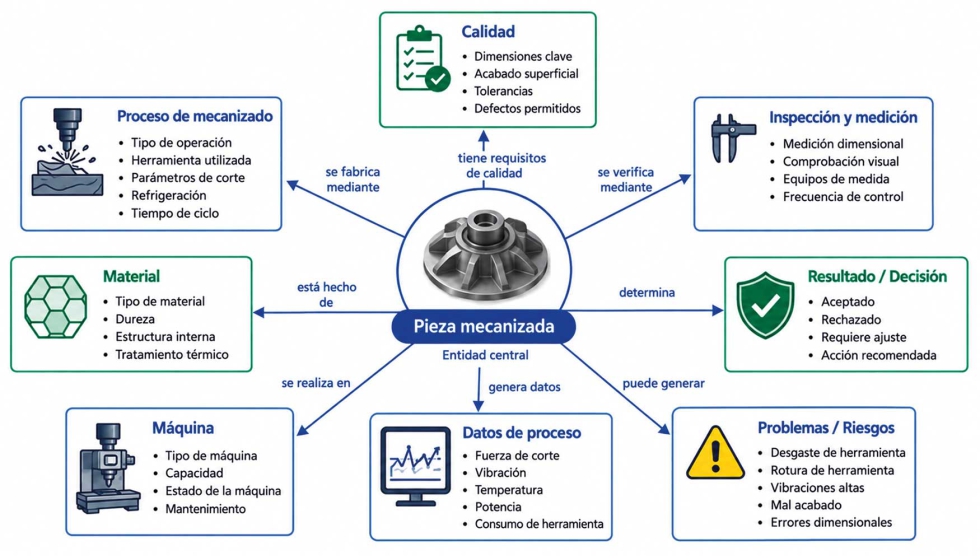
En una aplicación de mecanizado, una ontología puede relacionar una pieza con el material empleado, la máquina utilizada, los requisitos de calidad, las inspecciones realizadas, las señales registradas y los posibles problemas detectados. Como se muestra en la Figura 1, la pieza mecanizada actúa como elemento central y se conecta con la información más relevante de su ciclo de fabricación, permitiendo conocer de forma conjunta cómo se fabricó, qué recursos se utilizaron, qué datos se registraron, cómo se verificó su calidad y qué resultado se obtuvo. De este modo, la ontología establece un vocabulario común que facilita la conexión entre el lenguaje utilizado por los operarios y la información almacenada en los distintos sistemas industriales.
Sin embargo, una ontología permite describir el significado de los conceptos y las relaciones entre ellos, pero no muestra por sí sola qué ocurrió durante un proceso de fabricación concreto. Para responder preguntas sobre valores máximos, tendencias, comparaciones entre periodos o señales registradas antes de una alarma, es necesario consultar también los datos del proceso almacenados por la máquina. El sistema evoluciona así hacia un agente industrial capaz de interpretar la pregunta, decidir si debe consultar la ontología o la base de datos de series temporales, ejecutar una operación controlada y presentar el resultado en lenguaje natural. Su finalidad es facilitar el análisis y apoyar la toma de decisiones, sin modificar parámetros ni actuar directamente sobre la máquina.
Las preguntas relacionadas con el significado y la organización de las variables se resuelven mediante la ontología, por ejemplo:
- ¿Cuál es el rango de funcionamiento permitido de los servomotores de la máquina?
- ¿Qué variable representa la corriente del segundo husillo?
Por el contrario, las preguntas sobre lo ocurrido durante el proceso requieren consultar las señales registradas, por ejemplo:
- ¿Cuál fue el valor máximo del par durante el último ciclo?
- ¿Qué temperaturas se registraron entre el 16 de enero y el 12 de febrero?
Este artículo presenta una arquitectura de agente industrial orientada a la consulta de conocimiento semántico y datos de proceso. El sistema combina un modelo de lenguaje ejecutado localmente, una ontología que relaciona los conceptos industriales con las variables de máquina y una base de datos de series temporales TimescaleDB. Como caso de uso, se plantea su aplicación en una máquina de brochado, donde el usuario puede formular preguntas tanto sobre el significado de las señales como sobre los valores registrados durante el proceso.
TimescaleDB como repositorio de datos de proceso
En la monitorización industrial, las variables de proceso se registran habitualmente como series temporales, es decir, secuencias de valores ordenadas según el instante en el que fueron adquiridas. Esta estructura permite reconstruir la evolución del proceso y analizar el comportamiento de las señales en intervalos concretos, facilitando la identificación de tendencias, cambios o anomalías [2].
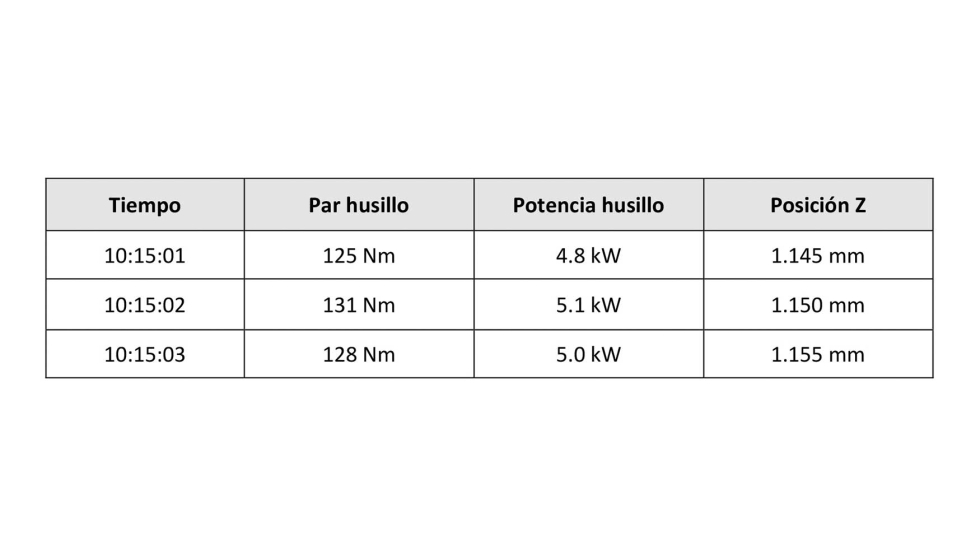
TimescaleDB [3] es una base de datos de código abierto basada en PostgreSQL y preparada para almacenar y analizar grandes volúmenes de datos temporales. En el prototipo desarrollado, la información se organiza, como se muestra en la Tabla 1, en una estructura donde cada fila representa un instante de adquisición y cada columna corresponde a una variable de la máquina.
Estas señales pueden proceder del CNC, del PLC, de sensores externos o de dispositivos de adquisición instalados en la máquina. El agente no sustituye estos sistemas, sino que proporciona una forma más sencilla de acceder a la información almacenada. Antes de realizar una consulta, comprueba qué variables existen realmente en la base de datos, evitando utilizar nombres incorrectos o inexistentes. De este modo, el usuario no necesita conocer la estructura de las tablas ni escribir consultas SQL, sino que puede formular sus preguntas utilizando el vocabulario habitual de producción o mantenimiento.
Funcionamiento del agente industrial
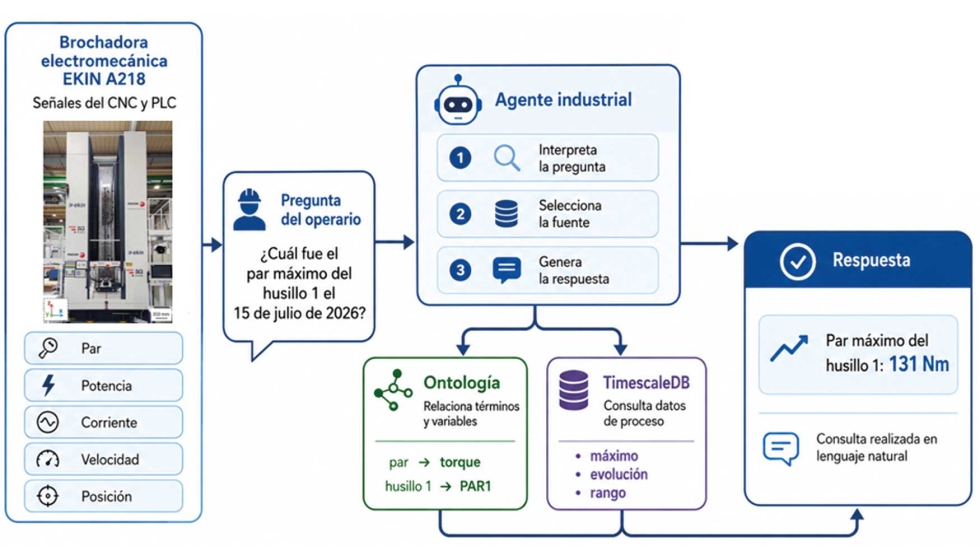
Una vez definidas las dos fuentes de información, tanto la ontología y la base de datos de series temporales, el siguiente paso consiste en coordinar su consulta. Para ello, el agente sigue el flujo mostrado en la Figura 2. En primer lugar, el modelo de lenguaje interpreta la consulta y crea un plan estructurado en el que identifica qué información se solicita, sobre qué elemento de la máquina, qué operación debe realizarse y qué periodo temporal debe analizarse. Por ejemplo, ante la pregunta “¿Se detectó algún valor anómalo en el par del husillo 1 entre las 10:00 y las 10:30 del 10 de julio de 2026?”, el sistema identifica la señal correspondiente al par del primer husillo, limita la consulta al intervalo temporal indicado y analiza los valores registrados para determinar si existen comportamientos anómalos.
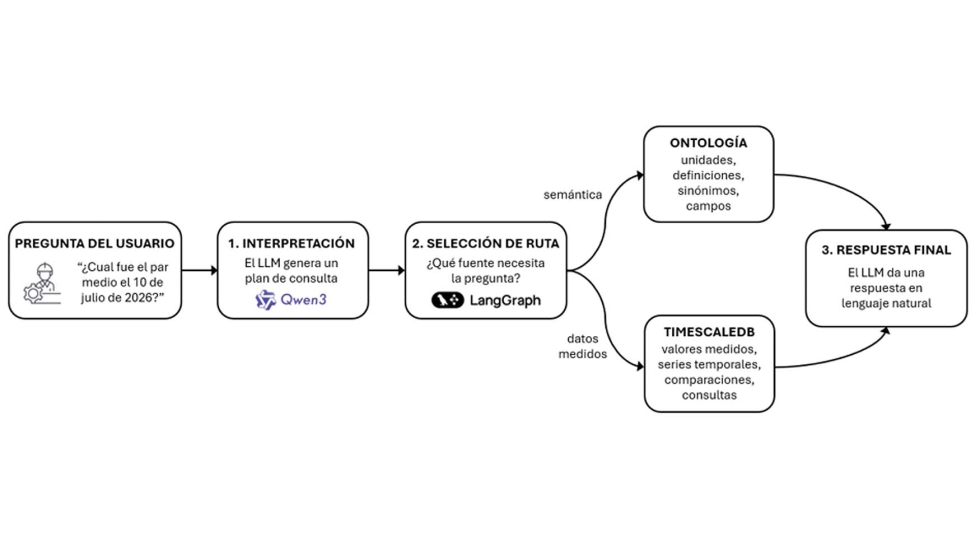
Antes de ejecutar la consulta, el sistema normaliza la pregunta para interpretar correctamente fechas, términos equivalentes y expresiones como máximo, mínimo, media, último valor o evolución. A partir de esta interpretación, LangGraph [4] coordina el flujo y selecciona la fuente adecuada. Las preguntas sobre unidades, definiciones, sinónimos o nombres de variables se dirigen a la ontología, mientras que las consultas sobre valores registrados, evoluciones temporales o comparaciones se envían a TimescaleDB.
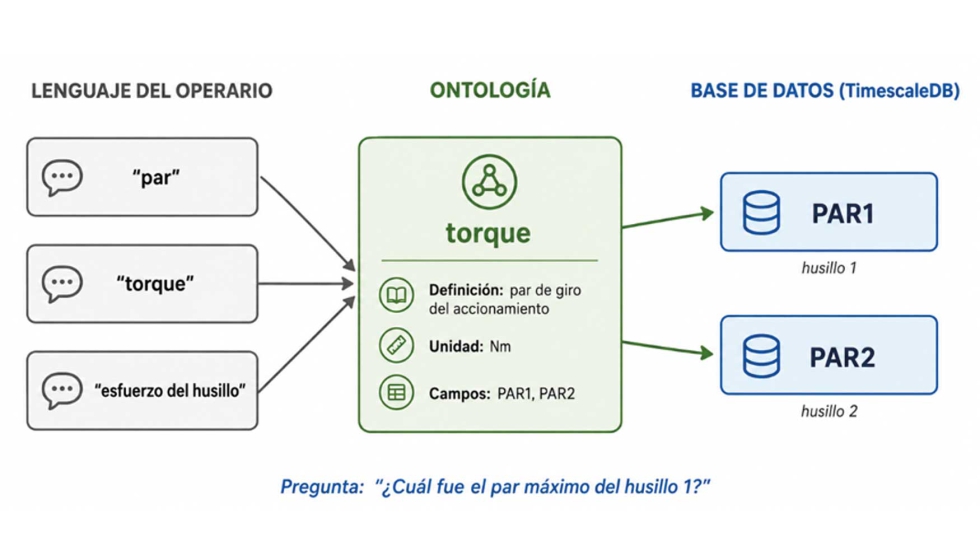
La ontología actúa como una capa de enlace entre el vocabulario empleado por los operarios y la nomenclatura interna de la base de datos. Como se muestra en la Figura 3, términos como par, torque o esfuerzo del husillo se asocian a una misma magnitud, mientras que la referencia al husillo 1 permite identificar el campo correspondiente, en este caso PAR1. Así, el usuario puede consultar la información mediante expresiones habituales del entorno de producción, sin necesidad de conocer los nombres técnicos de las señales almacenadas.
El acceso a TimescaleDB se realiza mediante consultas controladas y de solo lectura. El sistema comprueba previamente que las variables solicitadas existen y limita las operaciones permitidas, evitando que el modelo de lenguaje pueda modificar o eliminar información. Una vez obtenido el resultado, este se devuelve al LLM, que lo transforma en una respuesta clara y comprensible sin alterar los valores recuperados.
La ejecución local del modelo permite que las preguntas de los operarios, los nombres de las variables y los resultados de producción permanezcan dentro de la infraestructura de la empresa. De esta forma, la información del proceso no necesita enviarse a servicios externos, lo que facilita el control sobre los datos y contribuye a preservar su confidencialidad, un requisito especialmente importante en entornos industriales.
Caso de uso en CFAA: Brochadora electromecánica EKIN A218
En el Centro de Fabricación Avanzada Aeronáutica (CFAA) [5], el prototipo se ha desplegado sobre una brochadora vertical electromecánica EKIN A218, cuyos sistemas de adquisición (complementado con un dispositivo Edge de Savvy Data Systems) registran señales procedentes del CNC (Fagor 8070) y del PLC, como el par, la potencia, la corriente, la velocidad y la posición de los accionamientos. Como se observa en la figura 4, el brochado se ejecuta en una única pasada lineal en la que los dientes de la brocha entran progresivamente en contacto con la pieza y arrancan material de forma secuencial.
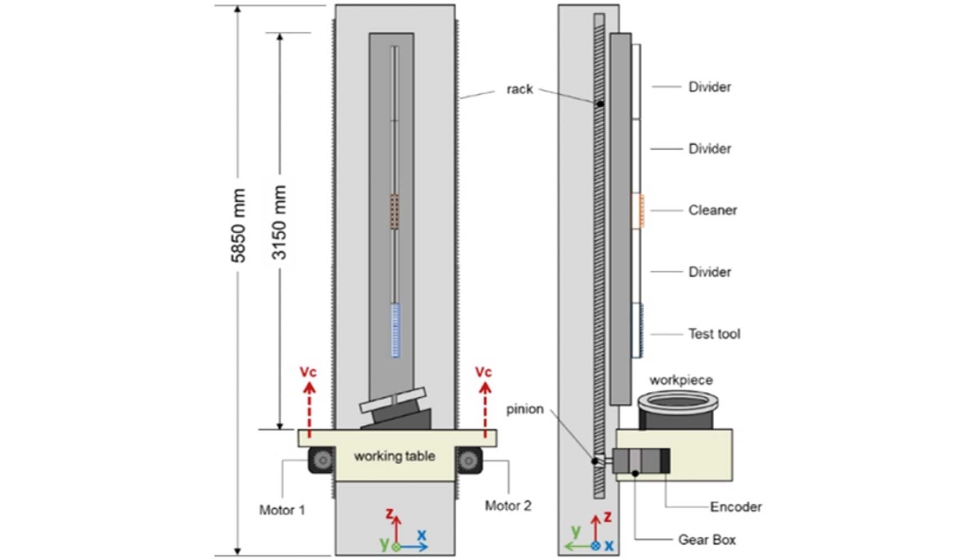
Para que el agente pueda razonar en estos términos, la ontología no describe únicamente magnitudes y accionamientos, sino también las entidades propias del proceso: la herramienta de corte, la pasada (el último brochado), la zona activa de corte y el estado de herramienta. Gracias a ello, una expresión como desde el último cambio de brocha deja de ser una referencia ambigua y se convierte en un intervalo concreto sobre el que operar.
La figura 5 resume el funcionamiento del caso de uso. En la parte izquierda se muestra la brochadora EKIN A218 junto con las principales variables monitorizadas. A partir de una pregunta formulada por el operario, el agente interpreta la solicitud, consulta la ontología para relacionar los términos empleados con las variables correspondientes y accede a TimescaleDB para recuperar los datos necesarios. Finalmente, el resultado se presenta en lenguaje natural y en un formato claro y directamente interpretable por el operario.
Conclusiones y trabajo futuro
El trabajo presentado muestra cómo la combinación de modelos de lenguaje, ontologías y bases de datos de series temporales puede facilitar el acceso a la información industrial mediante preguntas formuladas en lenguaje natural. En el caso de la brochadora EKIN A218, el agente permite relacionar el vocabulario utilizado por los operarios con las señales registradas por la máquina y consultar valores, evoluciones e intervalos temporales sin necesidad de conocer la estructura interna de la base de datos.
La principal aportación de la arquitectura no reside únicamente en utilizar un LLM, sino en integrarlo dentro de un flujo controlado. La ontología aporta el significado de los conceptos, LangGraph coordina la selección de la fuente y TimescaleDB proporciona los datos reales del proceso.
Como trabajo futuro, se propone integrar la arquitectura con tecnologías de interoperabilidad industrial. Por un lado, se plantea utilizar Asset Administration Shell (AAS) para organizar de forma común la información de máquinas, componentes y procesos, facilitando la conexión con equipos de distintos fabricantes. Por otro lado, se estudiará el uso de Model Context Protocol (MCP) como mecanismo para estandarizar la conexión del agente con nuevas fuentes de datos y herramientas externas.
También será necesario validar el sistema con preguntas reales de operarios e ingenieros, evaluando la interpretación de las consultas, la selección de variables, el tiempo de respuesta y su utilidad antes de extenderlo a otros procesos.
Agradecimientos
Este trabajo ha sido financiado por el Departamento de Industria, Transición Energética y Sostenibilidad del Gobierno Vasco a través del Programa ELKARTEK (Convocatoria 2026), en el marco del proyecto KRYSTAL (expediente KK-2026/00025). Asimismo, se ha desarrollado en el marco del proyecto ATHEMA (expediente ZE-2026/00038), financiado por el mismo Departamento a través del Programa HAZITEK (Convocatoria 2026) y cofinanciado por la Unión Europea a través del Fondo Europeo de Desarrollo Regional (FEDER), en el marco del Programa del País Vasco FEDER 2021-2027. Este trabajo también ha sido financiado por el Ministerio de Ciencia, Innovación y Universidades en el marco del proyecto LEIRE (PID2025-170545OB-I00).
Referencias
[1] Álvaro, J. A. H., & Barreda, J. G. (2025). An advanced retrieval-augmented generation system for manufacturing quality control. Advanced Engineering Informatics, 64, 103007.
[2] Brecher, C., Lohrmann, V., Weiler, P., Krömer, M., & Fey, M. (2025). Data usage in the internet of production: development of a process database for data-driven modeling. The International Journal of Advanced Manufacturing Technology, 141(11), 5781-5792.
[3] TimescaleDB. https://timescaledb.org/. Accedido el 11/09/2026.
[4] LangGraph. https://www.langchain.com/langgraph. Accedido el 08/09/2026.
[5] CFAA. https://cfaa.eus/. Accedido el 10/09/2026.
Autores
Endika Tapia Fernandez. Investigador del Centro de Fabricación Avanzada Aeronáutica.
Ingeniero informático en Gestión y Sistemas de Información en la Universidad del País Vasco. Su área principal de investigación es la computación paralela y distribuida, con especial atención a los siguientes temas: computación de alto rendimiento, sistemas de procesamiento de datos escalables y protocolos de comunicación industrial y conectividad.
Leonardo Sastoque Pinilla. Investigador del Centro de Fabricación Avanzada Aeronáutica.
Doctor en Ingeniería de proyectos enfocado en el uso de herramientas de Inteligencia Artificial a la gestión de proyectos 4.0, Máster en dirección de proyectos europeos e ingeniero aeronáutico. Está especializado en la gestión y desarrollo de proyectos de transformación digital e implementación de tecnologías 4.0. Cuenta con experiencia en ingeniería de procesos y proyectos, e implementación de sistemas de gestión.